
 Alexander Kaserbacher
08.03.2023
Die Pillar "Operational Excellence" bietet eine Menge an Praktiken, die ein System aus operativer Sicht beleuchten. Dieser Blogpost ist der zweite der Reihe "Well Architected Cloud" und beschäftigt sich näher mit dieser Pillar.
Die Pillar “Operational Excellence” kommt in allen drei Architekturframeworks der großen Cloud-Vendoren vor. Sie beinhaltet eine fundamentale Grundlage an Methoden, ohne denen viele Best Practices der anderen Pillars nicht umsetzbar wären.
Dieser Blogbeitrag bietet Ihnen einen schnellen Einstieg und Überblick in das Thema. Ich habe direkt die relevanten Inhalte der Frameworks referenziert, falls Sie an bestimmten Stellen weiter in die Tiefe gehen möchten. Die Namenskürzel der Verweise haben eine Bedeutung: Kürzel, die mit A beginnen, beziehen sich auf AWS, M auf Microsoft Azure und G auf Google Cloud.
Designprinzipien
Wie jede Pillar in den Architekturframeworks bietet auch “Operational Excellence” einen Satz von grundlegenden Designprinzipien. Ich habe die Designprinzipien aus allen drei Frameworks in Abbildung 1 zusammengefasst.
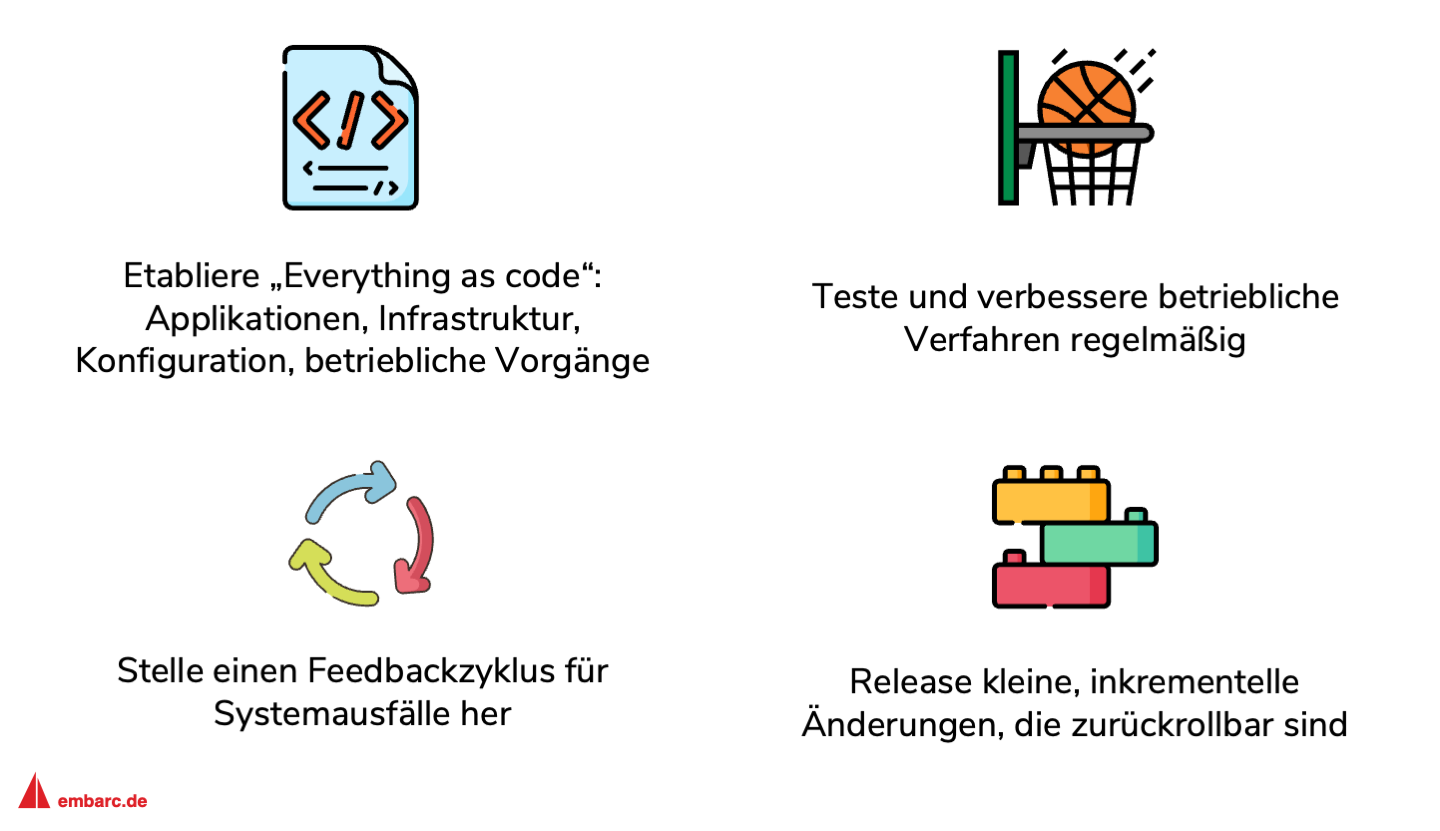
- Etabliere “Everything as code”: Applikationen, Infrastruktur, Konfiguration, betriebliche Verfahren. Damit erreichen Sie Nachvollziehbarkeit und Wiederherstellbarkeit. Von Ihrer Netzwerkinfrastruktur bis zu betrieblichen Vorgängen (z. B. Rollback-Prozesse) – wenn Sie diese Themen “in Code gießen”, dann können Sie auch alles in Ihrer Versionsverwaltung ablegen.
- Teste und verbessere betriebliche Verfahren regelmäßig. Betriebliche Verfahren sind Dinge, die rund um ein System gemacht werden müssen, z. B. Deployment, Systemwiederherstellung, Patches oder Rollbacks. Üben Sie diese Prozesse regelmäßig. Versetzen Sie sich auch künstlich in eine Fehlersituation, um unter anderem Wiederherstellungsprozesse nach Systemausfällen zu testen und zu üben. AWS nennt diese dedizierten Übungen “Game Days” [AGD]. Nutzen Sie daraus gewonnene Erkenntnisse, um betriebliche Verfahren regelmäßig zu verbessern.
- Stelle einen Feedbackzyklus für Systemausfälle her. Systemausfälle sind besondere Ereignisse, aus denen Sie lernen sollen. Stellen Sie sich folgende Fragen: Was hat zu dem Systemausfall geführt? Waren unsere Recovery-Mechanismen effektiv? Was können wir tun, um diese Situation in Zukunft zu verhindern?
- Release kleine, inkrementelle Änderungen, die zurückrollbar sind. Nutzen Sie die Monitoring- und Observability-Features der Cloud. Dadurch erhalten Sie schneller Feedback für Features und ermöglichen Konzepte wie A/B-Testing oder Canary Releases.
Im restlichen Teil des Blogposts stelle ich Ihnen einzelne Best-Practice-Bereiche der “Operational Excellence”-Pillar vor. Aggregiert aus den drei Architekturframeworks lassen sich die Best Practices grob in verschiedene Themenbereiche einteilen: Observability, Continuous Integration und Automatisierung/Infrastructure as Code.
Observability
Das Ziel von Observability ist, Anwendungs- und Systemverhalten nachvollziehbar zu machen. Einerseits ist es wichtig, im Fehlerfall schnell an Informationen zu gelangen, um das Problem zu beseitigen. Andererseits wollen wir nachvollziehen können, ob sich unser System so verhält, wie wir es erwarten – vor allem, ob wir unsere Geschäftsziele erreichen oder nicht.
Observability stützt sich daher auf Telemetrie-Daten:
- Metriken sind Zahlen, die ein System (kontinuierlich) meldet und uns etwas über dessen Zustand verraten. Ihre Pulsfrequenz ist eine Metrik Ihres Körpers. CPU- oder Speicherverbrauch eine Metrik von Softwaresystemen.
- Logs sind diskrete Ereignisse. Es ist etwas passiert, was wichtig ist und das System “meldet” das als Ereignis. Ein Beispiel wäre, dass der LogIn-Versuch eines Nutzers fehlgeschlagen ist.
- Traces sind Transaktionsinformationen. Cloud-Anwendungen sind verteilte Systeme, die aus einem Dschungel verschiedener Dienste zusammengestellt sind. Ein Trace ist ein konkreter Pfad einer Anfrage durch diesen Dschungel.
Alle diese Daten sind für Observability wichtig. Abbildung 2 zeigt einen Prozess, wie wir uns diese Daten zunutze machen können.

Key Performance Indicators (KPIs) definieren
Bevor wir uns technisch über die Auswertung von Telemetrie-Daten Gedanken machen, müssen wir festlegen, was wir überhaupt messen wollen. Das Framework von AWS gibt uns in [AAT] zwei Fragen an die Hand, die beim Ableiten von KPIs nützlich sind:
- Ist Ihre Anwendung in einem “healthy” Zustand?
- Erreicht Ihre Anwendung die gewünschten Geschäftsziele?
Sie sollten jederzeit in der Lage sein, diese Fragen zu beantworten. Definieren Sie Ihre KPIs zudem auf verschiedenen Ebenen. Bedenken Sie neben einer allgemeineren Geschäftsziel-Ebene auch detaillierte, technische Faktoren (z. B. Speicherverbrauch, Netzwerklatenz von technischen Komponenten) [AOH] [GMB].
Datenquellen
Identifizieren Sie ein breites Spektrum an Datenquellen für Telemetrie. Je mehr Datenquellen Sie integrieren, desto besser sind die Metriken, mit denen Sie die Erreichung Ihrer KPIs überprüfen können.
Mögliche Datenquellen sind:
- Anwendungsdaten werden direkt aus dem Applikationscode gewonnen. Damit sind Log-Messages oder Metriken gemeint, die durch Anweisungen im Code erzeugt werden. Auch Frameworks und Libraries loggen oft nützliche Informationen [AAT].
- Infrastrukturdaten spielen im Cloud-Umfeld eine große Rolle. Anwendungen benutzen eine Vielzahl an Services zur Ausführung, Datenhaltung oder Integration. Oft sind diese Services schon mit Metriken, Logs und Trace-Informationen versehen, die Sie mühelos integrieren können. Netzwerk-Infrastruktur oder Software-Infrastruktur, wie Betriebssysteme, Datenbankmanagementsysteme oder Container zählen auch zu dieser Kategorie.
- Betrachten Sie auch Daten aus Nutzeraktivitäten, z. B. Nutzertransaktionen (in der Benutzeroberfläche) oder die Reihenfolge von API-Calls (bei Fremdsystemen). Typischerweise müssen Sie dazu Applikationscode anpassen und Session-Daten von Nutzern (oder Fremdsystemen) betrachten. Daraus können Tracking-Systeme eine Reihenfolge von Aktionen ableiten. Mit diesen Daten können Sie erkennen, ob bestimmte Features benutzt werden oder Stellen identifizieren, an denen Wartezeiten für Nutzer:innen besonders hoch sind.
- Transaktionsdaten. Systeme in der Cloud sind über mehrere Dienste verteilt. Daher ist es sinnvoll, wenn Sie in der Lage sind, Anfragen an Ihr System nachzuverfolgen und deren Weg durch Ihre Dienstlandschaft zu kartografieren. Dazu müssen Sie Aufrufe in Ihrer Cloud-Landschaft einer bestimmten (Nutzer-)Transaktion zuordnen können.
Inspiration zu möglichen Datenquellen finden Sie in [MMS] oder [ADT], an denen sich die obige Auflistung orientiert.
Sammlung und Speicherung von Telemetrie-Daten
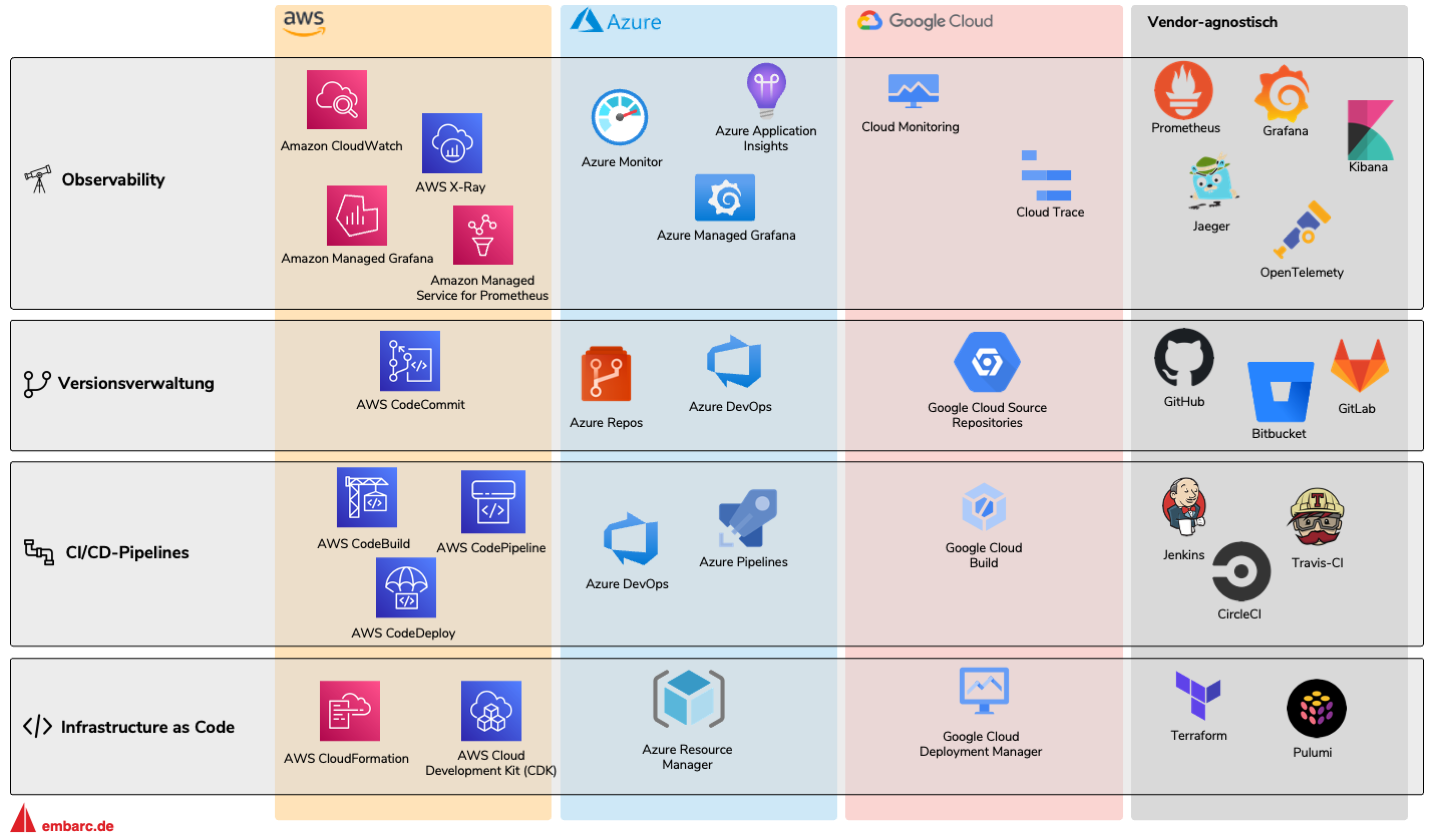
Achten Sie darauf, dass Sie die Telemetrie-Daten aus den oben genannten Quellen an einer zentralen und einheitlichen Stelle sammeln und speichern. Das Azure Well-Architected Framework hat eine gute Sektion, in der unterschiedliche Strategien aufgeführt sind [MCS]. Eine Sammlung unterschiedlicher Tools finden Sie in Abbildung 3.
Auswertung
Separieren Sie Telemetrie-Daten nach Wichtigkeit. Manche Daten müssen zeitnah analysiert werden, da sie für kritische Metriken notwendig sind. Andere Daten können später analysiert werden, da sie eher für Reports und zur weiteren Analyse verwendet werden.
Viele Telemetrie-Services bieten die Möglichkeit, aus aggregierten Log-Daten Metriken zu berechnen. Beispielsweise können Sie aus verschiedenen Log-Statements eine Fehlerrate berechnen und als Metrik verarbeiten.
Visualisierung und Alarme
Visualisieren Sie die in den vorherigen Schritten gesammelten und aufbereiteten Daten. Stellen Sie diese Visualisierungen auf einem zentralen Dashboard zur Verfügung.
Nutzen Sie diese Daten auch, um Alarme auszulösen. Alarme sind Mechanismen, die Sie in bestimmten Situationen über wichtige Ereignisse informieren. Diese sind gefährdend und haben direkte Auswirkungen auf Ihre Nutzer, z. B. wenn die Verfügbarkeit Ihrer Website nicht gegeben ist.
Stellen Sie sicher, dass Sie auf solche Alarme adäquat reagieren können [MMS]:
- Definieren Sie für jeden Alarm eine verantwortliche Personengruppe, sodass klar ist, welche Personen reagieren müssen
- Richten Sie zuverlässige Kanäle ein, damit die richtige Personengruppe zeitnah reagieren kann: Chat-Systeme, Pager oder SMS [AAL] [MAL] [GAL].
- Legen Sie für jeden Alarm klare Schritte fest, die die Verantwortlichen durchführen sollen. Vermeiden Sie Situationen, in denen Sie im Falle eines Alarms mögliche Ursachen und Maßnahmen erraten müssen.
Continuous Integration
Um Operational Excellence zu erreichen, müssen wir uns Gedanken über unsere Systeme und Entwicklungsprozesse machen. Alle drei Frameworks legen den Fokus auf solche Themen [ADO] [MCI] [GAD].
- Versionskontrollsysteme bilden die Grundlage für Continuous Integration. Achten Sie darauf, dass Ihr Versionskontrollsystem Unterstützung für Automatisierung bietet und leicht integrierbar ist.
- Nutzen Sie Testautomatisierung, damit Teams schnell Feedback über unerwartetes Verhalten bekommen. Schreiben Sie einerseits funktionale Tests (wie Unit-, Integrations- oder Systemtests). Führen Sie andererseits auch Performance- oder Stress-Tests ein, in denen Sie Fehlerszenarien nachstellen, um Ihre Recovery-Mechanismen (manuell oder automatisiert) zu testen und zu üben. Eine gute Übersicht über verschiedene Arten von Tests liefert das Azure Well-Architected Framework [MRT].
- Werkzeuge für Konfigurationsmanagement ermöglichen es Ihnen, Konfigurationsparameter aus der Verantwortlichkeit des Programmcodes zu nehmen und in einem zentralen Register abzulegen. Nun können Sie die Konfiguration für Ihren Programmcode zur Laufzeit verwalten und ändern. Damit können Sie beispielsweise Feature Toggles umsetzen oder A/B-Testing erleichtern.
- Nutzen Sie Konzepte wie Pair Programming, Pull Requests in Verbindung mit einem Branching-Modell (oder Trunk-Based Development [TBD] als Alternative) in Ihrem Entwicklungsprozess. Finden Sie heraus, welche Konzepte für Sie funktionieren und welche nicht.
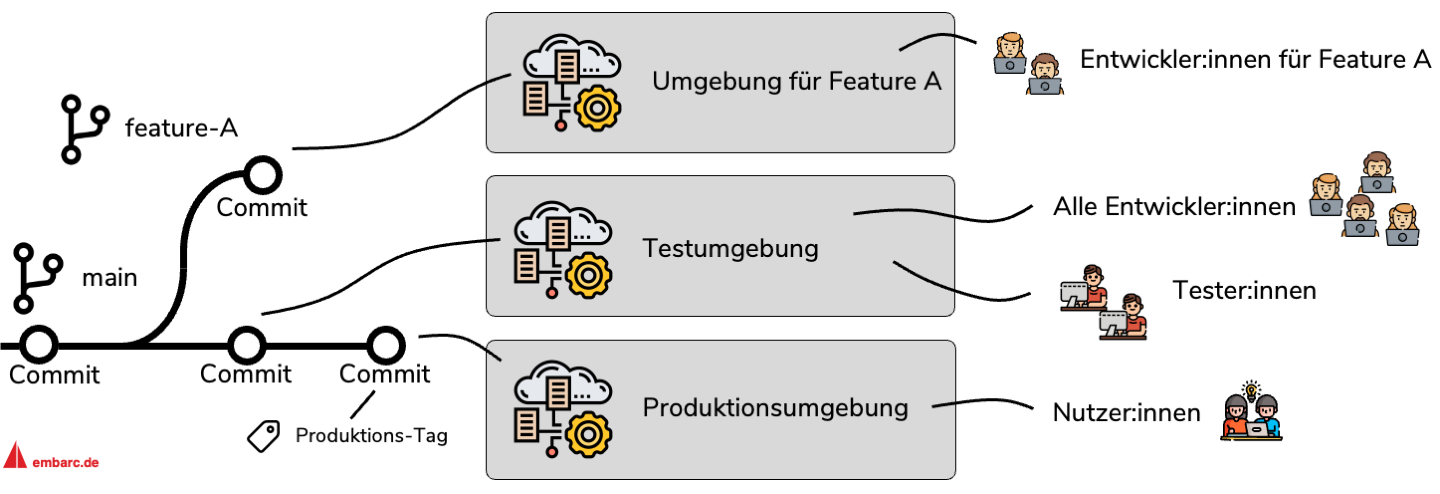
- Nutzen Sie den Vorteil verschiedener Deployment-Umgebungen. Trennen Sie Umgebungen für Entwicklung, Testing oder Produktion. Viele Teams nutzen die Automatisierungsmöglichkeiten der Cloud, um automatisch solche Umgebungen zu erstellen und wieder zu entfernen. Dieses Vorgehen ermöglicht Ihnen, für einzelne Features kostengünstig temporäre Umgebungen zu deployen, in denen die beteiligten Entwickler Ihre Änderungen testen können. Oft ist die Erstellung dieser Umgebungen an ein Branching-Modell in Git verknüpft [OPG]. Abbildung 4 verdeutlicht dieses Konzept.
- Automatisieren Sie Integrations- und Deployment-Pipelines. Ausgehend vom Versionskontrollsystem sollten die oben genannten Konzepte automatisiert oder tool-gestützt durchgeführt werden. Abbildung 3 sammelt einige Werkzeuge zur Umsetzung von Pipelines.
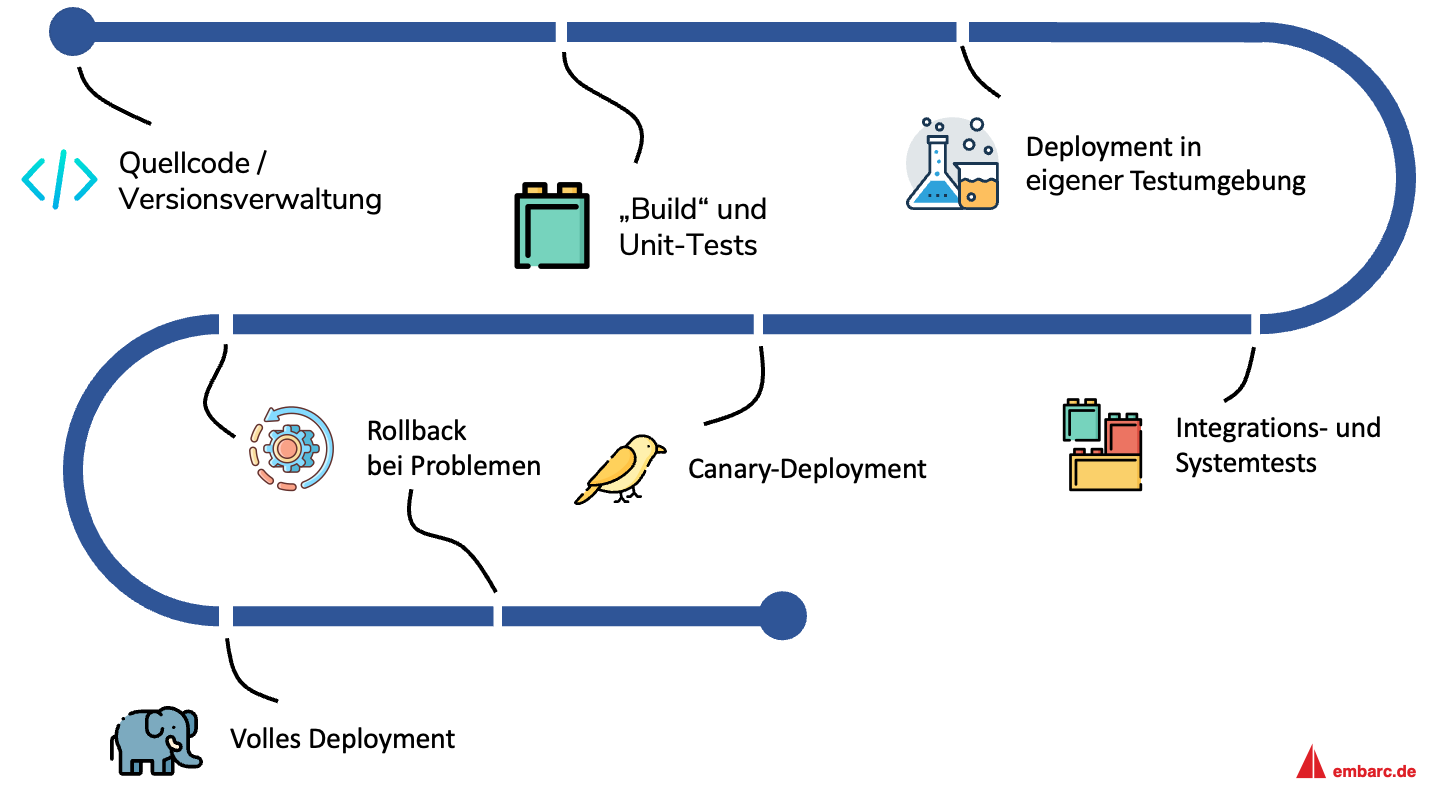
Am Ende einer solchen Pipeline findet ein automatisches Deployment statt. Canary-Deployments sind ein Mechanismus zur Minimierung des Risikos, unbeabsichtigt Fehler einzuführen. Dabei werden einzelne Features des Systems vorerst nur für eine kleine Nutzergruppe aktiviert. Dadurch betreffen mögliche Probleme nicht die gesamte Nutzerbasis und können leichter zurückgerollt werden. Eine Übersicht von weiteren Best Practices zur Senkung des Deployment-Risikos finden Sie in den Architekturframeworks [AMR] [MDE] [GAD].
Zusätzlich habe ich die oben genannten Konzepte in einer schemahaften Pipeline in Abbildung 5 verortet.
Automatisierung und Infrastructure as Code
Automatisierung ist ein zentraler Baustein der “Operational Excellence”-Pillar. Allgemein geht es um die Minimierung von “Toil” (englisch für Mühsal). Dieser Begriff wird in den Frameworks regelmäßig benutzt und bezeichnet operative Arbeit, die wenig Mehrwert bietet und eigentlich automatisierbar ist [MTO].
Infrastructure as Code ist eine populäre Methode zur Automatisierung. Meistens handelt es sich bei diesem Konzept um einen deklarativen Ansatz. Im Gegensatz zum imperativen Ansatz definieren Sie hier einen erwarteten Zielzustand (also die Ressourcen, die Sie in Ihrer Cloud-Umgebung benötigen und deren Konfiguration) und delegieren die Ableitung der notwendigen Schritte zur Erreichung dieses Zielzustandes an ein Automatisierungstool. Einige Werkzeuge für diesen Ansatz finden Sie in Abbildung 3.
Doch nicht alle operativen Aspekte müssen immer vollständig automatisiert sein. Runbooks und Playbooks sind zwei Konzepte, die hier ergänzend hilfreich sind. Runbooks sind eine dokumentierte Serie von operationellen Aktionen, die dazu dienen, ein bestimmtes Ziel zu erreichen. Häufige Beispiele für Runbooks sind eine Auflistung von manuellen Schritten, die bei großen Releases durchzuführen sind. Sobald Sie Runbooks dokumentiert und zentral abgelegt haben, sollten Sie diese je nach Priorität komplett automatisieren [ARB] [MOT].
Playbooks sind eine Hilfestellung, die Sie verwenden können, um Zwischenfälle (z. B. Systemausfälle oder langsame Systemteile) besser analysieren zu können. Sie beschreiben einzelne Schritte, die Sie durchführen sollen, um die Ursache zu identifizieren. Sie sind meistens offener als Runbooks und behandeln eher Punkte wie “Performance-Logs auf Ausreißer prüfen” anstatt konkreter, automatisierbarer Anweisungen [APB].
Die Blogreihe
Das war der zweite Beitrag in der Blogreihe “Well Architected Cloud”. Unten finden Sie eine Auflistung aller bisherigen Artikel. Nächste Woche werden wir uns die Security-Pillar genauer anschauen.
Sie möchten sich zum Thema “Operational Excellence” oder den Architekturframeworks der Cloud-Anbieter austauschen? Melden Sie sich gerne, meine Kontaktdaten finden Sie hier.
Weitere Blogposts in dieser Reihe
“Well Architected Cloud: ein Überblick über drei Architektur-Ratgeber”
“Well Architected Cloud: die Security-Pillar”
“Well Architected Cloud: die Reliability-Pillar”
‘Well Architected Cloud: die “Performance Efficiency”-Pillar’
“Well Architected Cloud: die Pillars “Cost Optimization” und Sustainability”
“Well Architected Cloud: die Architektur-Frameworks effektiv und effizient einsetzen”
Weiterführende Links
“Die Pillar im AWS Well-Architected Framework”
“Die Pillar im Azure Well-Architected Framework”
“Die Pillar im Google Cloud Architecture Framework”
Referenzen
[AAL] “Alert when workload outcomes are at risk”
[AAT] “Implement application telemetry”
[ADO] “Design for operations”
[ADT] “Design telemetry”
[AGD] “Build Your Own Game Day to Support Operational Resilience”, Blogpost von Lewis Taylor und Haresh Nandwani, September 2021
[AMR] “Mitigate deployment risks”
[AOH] “Understanding operational health”
[ARB] “Use runbooks to perform procedures”
[ARE] “Responding to events”
[GAD] “Automate your deployments”
[GAL] “Set up alerting”
[GMP] “Create a monitoring plan”
[OPG] “GitOps”
[MAL] “Alerting for operations”
[MCS] “Collect, aggregate, and store monitoring data for cloud applications”
[MCI] “Release Engineering: Continuous Integration”
[MDE] “Release Engineering: Deployment”
[MMS] “Data sources for diagnostic data”
[MOT] “Operational tasks”
[MPI] “Monitoring workloads”
[MRT] “Testing your application and Azure environment”
[MTO] “Automate toil to improve efficiency”
[TBD] “Trunk Based Development”