
 Stefan Zörner
22.09.2026
Für diesen Beitrag habe ich ausprobiert, wie viel von den Kommentaren in einem Code-Repository sich in einer KI-generierten Dokumentation wiederfindet, und woher die Informationen sonst stammen könnten. Das Ergebnis ist überraschend, wenn auch nicht ohne Weiteres auf jedes Projekt übertragbar.
In einem früheren Blog-Beitrag hatte ich den DeepWiki-Ansatz von Cognition und einige Alternativen dazu aus der Open-Source-Welt vorgestellt. Beim Schreiben gingen mir verschiedene Fragestellungen durch den Kopf, die ich aus Platzgründen nicht weiter ausgeführt habe. In diesem Beitrag vertiefe ich einen solchen Aspekt: Welchen Einfluss haben Kommentare im Source-Code auf die generierten Inhalte?
Die Fragestellung
Zur Erinnerung: DeepWiki & Co. leiten aus einem Quelltext-Repository mit Hilfe eines Large Language Models (kurz LLM) automatisiert eine Wiki-artige Dokumentation ab. Beim Blick auf die generierten Texte stellt sich die Frage, was Einfluss auf sie hat. Hier ein Beispiel aus einer solchen Dokumentation erstellt mit CodeWiki für DokChess, direkt aus dem Überblick zu Beginn.
The dokchess-en repository implements a fully functional chess engine written in Java. It provides a complete chess playing system with support for standard chess rules, move validation, opening book integration, and text-based user interface through the XBoard protocol.
(CodeWiki 1.0.1 mit Qwen3-Coder-Flash über DokChess)
Das Textfragment ist inhaltlich korrekt. Interessanterweise stammt es aus einem Lauf von CodeWiki gegen den englischen Quelltext von DokChess, aus dem ich zuvor sämtliche Kommentare entfernt hatte. Woher also “weiß” die AI das eigentlich?
Als Informationsquellen kämen grundsätzlich folgende Dinge infrage:
- Dokumentation, die als Textdateien im Repo mit eingecheckt ist, z.B. die README.md oder Architecture Decision Records (ADRs)
- Kommentare, die im Quelltext stehen. Etwa Interface-Beschreibungen, oder auch detaillierte Hinweise innerhalb von Methoden ("// …")
- Der Quelltext selber, insbesondere Bezeichner (z.B. Paket- und Klassennamen), Abläufe und Beziehungen
- Wissen aus den Trainingsdaten des verwendeten LLMs, zum Beispiel getriggert aus Kommentaren oder Bezeichnern
- Infos, die sich das LLM “eigenmächtig” über Tools erschließt, etwa durch Suchaufrufe im WWW.
Die beiden ersten Punkte entfielen beim Beispiel oben, der letzte auch. Übrig bleiben der Quelltext selber und die Trainingsdaten des LLMs.
Das Experiment
In der Praxis kommt dünn dokumentierter Quelltext recht häufig vor. Bei klassischen Dokumentationsgeneratoren wie Doxygen bleiben die erzeugten Seiten bei fehlenden Kommentaren abgesehen von Signaturen und Abhängigkeitsgraphen leer. DeepWiki & Co. können diese Lücken mit Text füllen. Aber was kommt dabei raus?
Um das herauszufinden habe ich zwei Open-Source-Projekte (siehe Tabelle 1) systematisch ihrer Quelltextkommentare beraubt: umoria ist ein Ableger des Dungeon Crawlers Moria aus der Unix-Welt von 1987. Die Schach-Engine DokChess dient schon seit langem als Standard-Beispiel für Architekturdokumentation mit arc42.
| Software (Repo verlinkt) | Umfang des Quelltextes in Lines of Code | Im Quelltext enthaltene Kommentare |
|---|---|---|
| Dungeons of Moria, umoria | 51 C++- und 26 Header-Dateien, 23.9k LOC | 21.834 Wörter, 4.172 x Kommentarzeilen `//` |
| DokChess, dokchess-en | 43 Java-Dateien, 4.1k LOC |
4.219 Wörter, 198 x Kommentarblöcke Javadoc |
Als Doku-Generator habe ich die Open-Source-Lösung CodeWiki genutzt, weil ich die Implementierung einsehen kann und volle Kontrolle darüber habe, was bei der Interaktion mit dem LLM passiert. Beim proprietären DeepWiki wären mir da die Hände gebunden.
Konkret wollte ich wissen:
- Inwieweit übernimmt CodeWiki vorhandene Kommentare in seine Texte?
- Was passiert, wenn die Kommentare fehlen: Bleibt die Dokumentation sinnvoll?
- Woher wissen CodeWiki und das LLM Dinge, die weder im Code noch in Kommentaren stehen?
Abbildung 1 zeigt den Versuchsaufbau. Dabei sammelt ein Python-Skript die Quelltextkommentare beim Entfernen ein und schreibt sie in eine Textdatei (1). Anschließend (2) erzeugt CodeWiki Dokumentation für beide Fassungen (einmal mit, einmal ohne Kommentare). Die Software nutzt ein nicht-deterministisches LLM zum Clustering in Module, zur Exploration der Quelltexte, zum Ausformulieren … Um auf Nummer sicher zu gehen habe ich die Läufe daher jeweils dreimal durchgeführt.
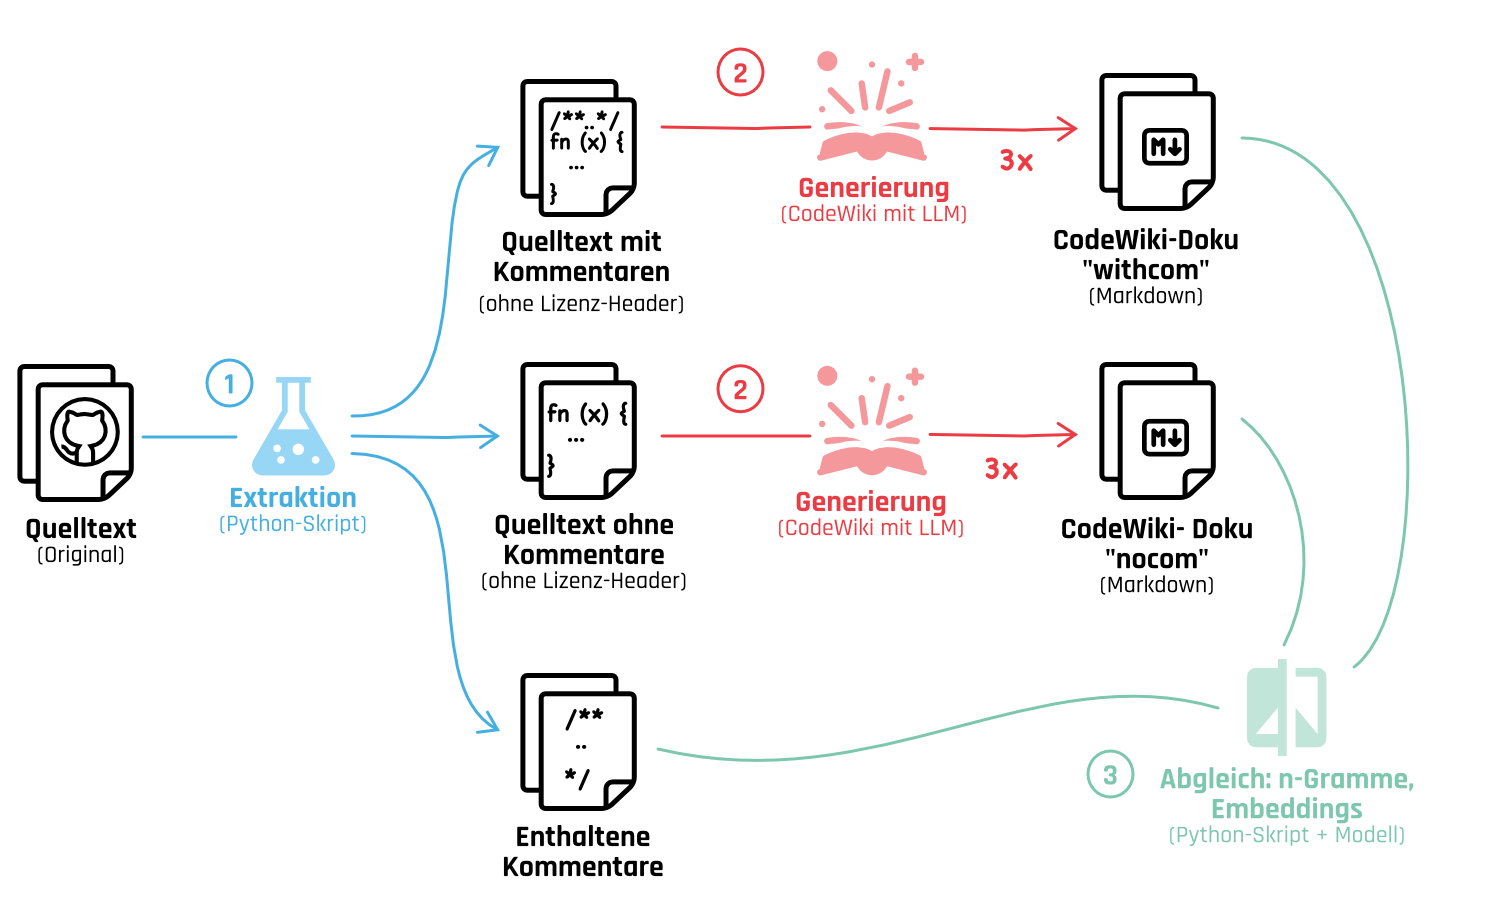
Die erzeugte Dokumentation habe ich bezüglich der Kommentare analysiert (3): Finden sie sich in der Fassung, welche die Kommentare gesehen hat, wieder? Der Lauf ohne Kommentare dient der Kontrolle (sogenanntes Nullmodell). Denn Kommentare und generierte Dokumentation könnten sich auch ähneln, ohne dass CodeWiki die Kommentare gesehen hat. Erst ein Vergleich beider Läufe erlaubt es, eine etwaige Übereinstimmung einzuordnen.
Mess-Ergebnisse für CodeWiki-Läufe
Als Erstes ein Blick in den Wortschatz aus Kommentaren und Bezeichnern. Englische “Allerweltswörter” (the, this, and, …) habe ich nicht mitgezählt und Bezeichner zerlegt (z.B. handleEvent -> handle, event), siehe Abbildung 2 für umoria. 33,8 % der in Kommentaren vorkommenden Wörter finden sich auch in Bezeichnern wieder (z.B. dungeon, player). Berücksichtigt man die Wortvorkommen in den Kommentaren, sind es sogar 60,6 %. Denn gerade die häufig verwendeten Wörter gehören zur Schnittmenge.
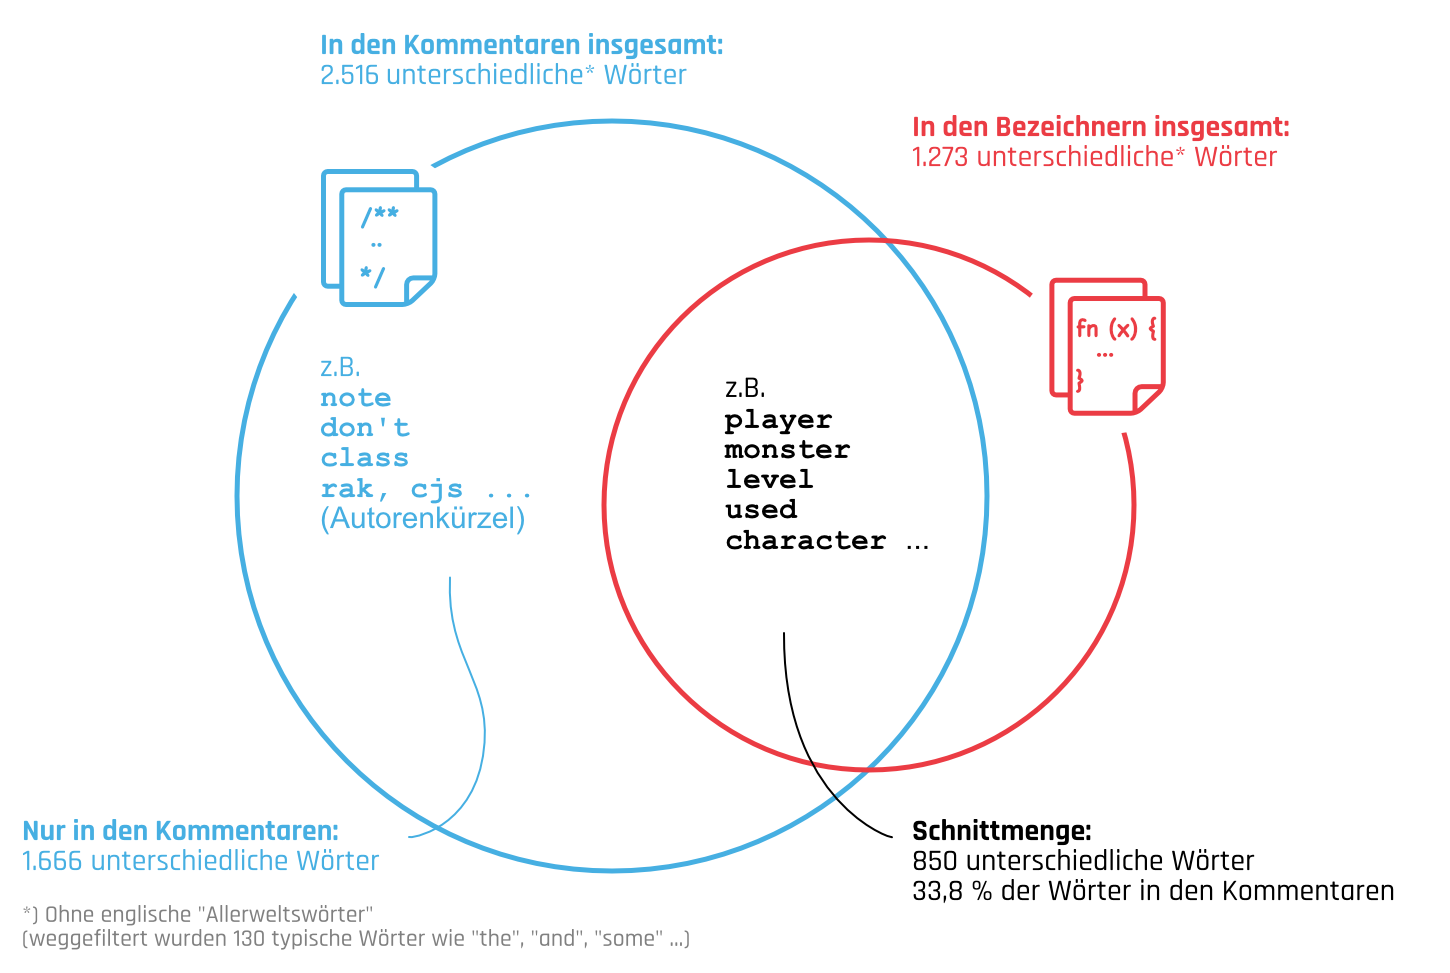
Bei DokChess sieht es ähnlich aus: einzelne Wörter 30,7 % bzw. mit Vorkommen gerechnet 58,1 %. Häufigste gemeinsame Wörter: move, position und square. Die große Überlappung erklärt, warum CodeWiki bzw. das LLM auch ohne die Kommentare ganz passable Texte formulieren kann, siehe das Beispiel oben.
Nun habe ich mich allerdings nicht auf die Suche nach einzelnen Wörtern in der generierten Dokumentation gemacht. Stattdessen war mein erster Ansatz, nach sogenannten N-Grammen zu suchen. Das sind Ketten von Wörtern der Länge N. Abb. 3 zeigt eine solche Folge von 12 Wörtern aus dem Quelltext von umoria (im Bild oben), also ein 12-Gramm, das 1:1 in einer generierten Markdown-Datei aus der Dokumentation auftaucht (im Bild unten).
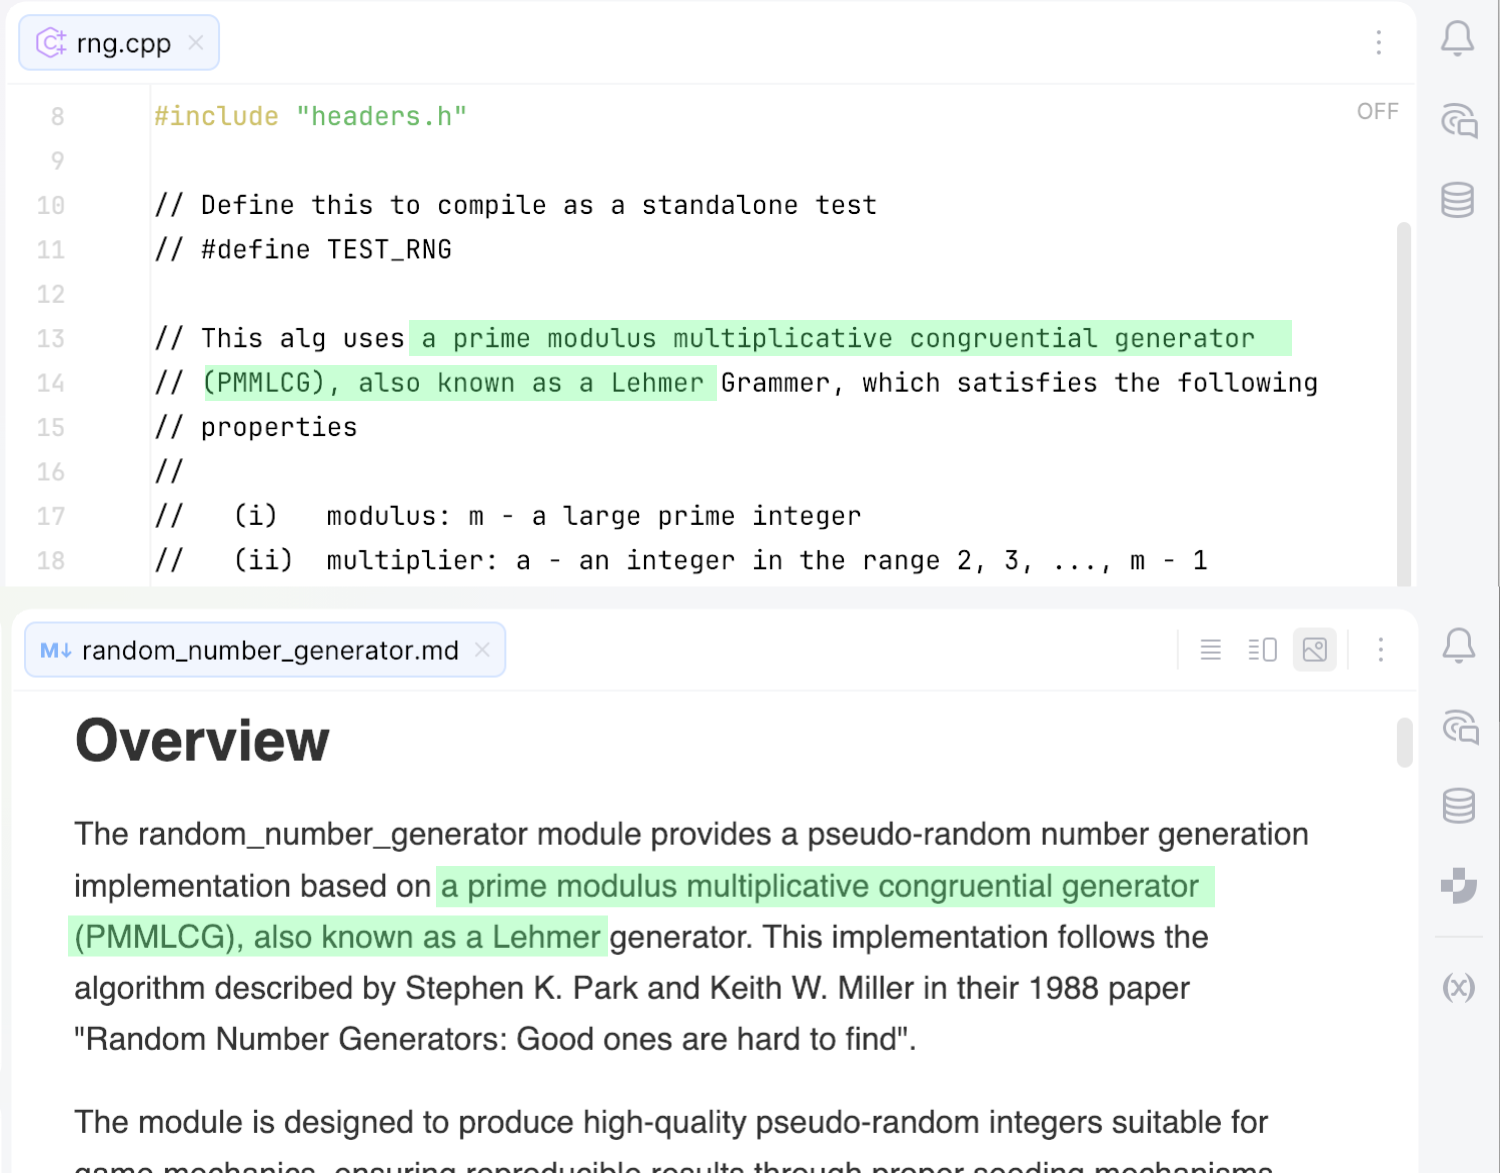
Tabelle 2 zeigt einen Ausschnitt des Ergebnisses für umoria, CodeWiki mit Qwen3-Coder-Flash. 2,75 % bei n=3 bedeutet, dass dieser Anteil aller 3-Gramme aus der generierten Dokumentation wortgleich in den extrahierten Kommentaren zu finden ist. Die Vergleichsspalte (“Nullmodell”) zeigt, dass die Übereinstimmungen ohne Kommentare im Input bei größerem n schneller verschwinden. Ab n=7 findet sich dort keine einzige mehr. Insgesamt sind die Zahlen aber sehr klein. Das liegt vielleicht daran, dass das LLM gerne frei mit den Wörtern spielt. Bereits ein Vertauschen von zwei Wörtern macht ein N-Gramm kaputt.
| n | mit Kommentaren | ohne Kommentare (zum Vergleich) |
|---|---|---|
| 3 | 2,75 % | 2,32 % |
| 5 | 0,22 % | 0,04 % |
| 8 | 0,06 % | 0,00 % |
| 11 | 0,01 % | 0,00 % |
Ich habe daher auch noch eine Messung mit Embeddings gemacht, das sind numerische Repräsentationen komplexer Daten wie z.B. Text. Sie erlauben, Bedeutungen und Beziehungen zwischen Objekten mathematisch darzustellen. Konkret habe ich die gleichen Daten wie bei den N-Grammen benutzt, aber statt auf wortgleiche Ketten auf inhaltliche Nähe geprüft.
Zur Illustration hier ein Ausschnitt aus dem Quelltext von umoria (Datei player_tunnel.cpp). Die Funktion playerDiggingAbility enthält einen Kommentar über der Signatur und auch einige innerhalb des Rumpfes.
// Compute the digging ability of player; based on strength, and type of tool used
static int playerDiggingAbility(Inventory_t const &weapon) {
    int digging_ability = py.stats.used[PlayerAttr::A_STR];

    if ((weapon.flags & config::treasure::flags::TR_TUNNEL) != 0u) {
        digging_ability += 25 + weapon.misc_use * 50;
    } else {
        digging_ability += maxDiceRoll(weapon.damage) + weapon.to_hit + weapon.to_damage;

        // divide by two so that digging without shovel isn't too easy
        digging_ability >>= 1;
    }

    // If this weapon is too heavy for the player to wield properly,
    // then also make it harder to dig with it.
    if (py.weapon_is_heavy) {
        digging_ability += (py.stats.used[PlayerAttr::A_STR] * 15) - weapon.weight;

        if (digging_ability < 0) {
            digging_ability = 0;
        }
    }

    return digging_ability;
}
In einer mit CodeWiki generierten Dokumentation aus Quelltext mit Kommentaren findet sich in den Details folgende Passage. Sie scheint Informationen aus den Kommentaren zu nutzen, etwa dass die Stärke des Spielers bei der Fähigkeit zum Graben eine Rolle spielt.
### playerDiggingAbility Function

Calculates the player's digging effectiveness based on:
- Strength attributes
- Weapon properties (tunneling flags)
- Weapon damage characteristics
- Weight considerations for heavy weapons
Um zu überprüfen, ob es tatsächlich einen Unterschied macht, ob Kommentare zur Verfügung stehen, habe ich für jeden Satz der generierten Dokumentationen (Quelltext mit und ohne Kommentare als Basis) die höchste Ähnlichkeit zu einem der extrahierten Kommentare bestimmt.
Zum Einsatz kam dabei ein kleines, frei verfügbares Modell (all-MiniLM-L6-v2). Die Ähnlichkeit der Sätze “Compute the digging ability of player; based on strength, and type of tool used” und “Calculates the player’s digging effectiveness based on:” bezüglich dieses Modells beträgt 0,826, was ein recht hoher Wert ist. 1,0 würde vollständige Übereinstimmung bedeuten.
Mit einem Skript habe ich für umoria zu jedem Satz aus den mit CodeWiki generierten Dokumentationen (mit und ohne Kommentare im Input) denjenigen Satz in den extrahierten Kommentaren gesucht, der die höchste Ähnlichkeit bezüglich des Modells aufweist. Tabelle 3 zeigt einige Kennzahlen dazu.
Der Median ist der mittlere Wert, wenn man die Ähnlichkeiten nach Größe aufreiht. Das “90. Perzentil” ist der Wert, unter dem 90 % aller verglichenen Kommentare liegen. In beiden Fällen unterscheiden sich die Läufe mit und ohne Kommentare kaum, die Dokumentation ist also im Wesentlichen gleich ähnlich zu den Kommentaren. Unabhängig davon, ob CodeWiki die Kommentare gesehen hat oder nicht. Lediglich beim Anteil der Sätze in der Dokumentation, die sehr ähnlich zu den Kommentaren sind (mindestens 0,80 wie das Beispiel oben), liegt der Lauf, der die Kommentare gesehen hat, deutlich vorn (aber bei kleinen Werten).
| Kennzahl | mit Kommentaren | ohne Kommentare (zum Vergleich) |
|---|---|---|
| Median | 0,538 | 0,537 |
| 90. Perzentil | 0,658 | 0,655 |
| Anteil Sätze ≥ 0,80 | 0,75 % | 0,47 % |
Die Ergebnisse sahen mit DokChess sehr ähnlich aus. Um ehrlich zu sein war ich überrascht, ich hätte mit höheren Abweichungen gerechnet. Sowohl bei den N-Grammen als auch bei den Embeddings.
CodeWiki ist in der Lage, allein anhand der Bezeichner, Signaturen und der Quelltextlogik Sätze zu produzieren, die Quelltextkommentaren zufällig sehr ähnlich sehen. Hier ein konkretes Beispiel aus DokChess.
Ein Javadoc-Kommentar zu Piece.is(Colour c) lautet „Test whether the piece has the given colour." In der Dokumentation aus einem Lauf mit Kommentaren heißt es „Tests if the piece matches a given color" (Ähnlichkeit 0,926). In der Dokumentation ohne Kommentare im Input findet sich „Checks if the piece matches a specific color" (Ähnlichkeit 0,905). Die Werte liegen in derselben Größenordnung, eine hohe Ähnlichkeit zwischen generiertem Text und Kommentar ist also für sich genommen kein Beleg für eine Übernahme. Dieselbe Aussage lässt sich rein aus dem Methodennamen und der Signatur ableiten.
Kennen die Modelle die Projekte?
Ich vermute, dass CodeWiki bzw. das LLM vor allem auf den Wortschatz aus den Bezeichnern zurückgreift, wenn Kommentare fehlen. Aber eine der eingangs genannten Informationsquellen habe ich damit noch nicht ausgeschlossen: Wissen aus den Trainingsdaten. DokChess und umoria sind schließlich keine völlig unbekannten Softwaresysteme.
Um zu testen, ob die eingesetzten Modelle die Projekte kennen, habe ich ihnen mit einem Skript via OpenRouter eine Frage gestellt (“Describe the structure and implementation of the DokChess chess engine.”), und die Antworten nach Prüfwörtern zur Implementierung gescannt (z.B. “Polyglot”, “XBoard”). Tabelle 4 zeigt die Ergebnisse, wobei ich jedes LLM fünfmal angefragt habe. Da die Antworten zwischen den Wiederholungen schwankten, zeige ich den Mittelwert der gefundenen Begriffe je Anfrage.
| DokChess | umoria |
|
|---|---|---|
| Prompt | Describe the structure and implementation of the DokChess chess engine. | Describe the structure and implementation of the Umoria computer game. |
| Prüfwörter | XBoard, ChessRules, Polyglot, MinimaxParallelSearch, Zörner | Roguelike, C++, Curses, Koeneke, Wilson |
| Qwen3-Coder-Flash | Gefunden 0 von 5 | Gefunden 2,2 von 5 |
| Claude Sonnet 5 | Gefunden 0 von 5 | Gefunden 3,2 von 5 |
Bezüglich Details zu DokChess, auch wenn es als arc42-Beispiel beiden Modellen bekannt ist (separate Testfrage), waren die LLMs nicht auskunftsfähig. Auf die Frage nach Struktur und Implementierung aus der Tabelle gingen die Antworten im Grunde alle los wie das folgende Zitat.
“DokChess” isn’t something I have reliable knowledge about — I can’t recall specific details about its architecture, design decisions, or implementation from verified training data.
(Claude Sonnet 5)
Wenn man sich hingegen die Rückmeldungen zu umoria im Detail anschaut, ist Wissen zur Funktionalität vorhanden, aber nicht zur Struktur der Software im Detail. Roguelike als Genrebezeichnung war dabei erwartungsgemäß fast immer Teil der Antwort. Aussagekräftiger sind die Treffer bei den Autorennamen, die ebenfalls häufig genannt wurden. Ebenso, dass C bzw. C++ die Implementierungssprache ist.
Unterm Strich könnte CodeWiki zumindest bei umoria mit beiden Modellen auf Allgemeinwissen zurückgreifen, wenn es darum geht, die Architektur überblicksartig zu beschreiben. CodeWiki macht ja beispielsweise immer eine Einstiegsseite (“Overview”). Es lässt sich nicht ausschließen, dass Dinge aus dem Trainingswissen dort einfließen. Wahrscheinlicher ist aber, dass Informationen aus dem Quelltext selbst im Rahmen des agentischen Workflows über die hierarchische Zerlegung bis in die zusammenfassende Repository-Übersicht “hochgespült” werden.
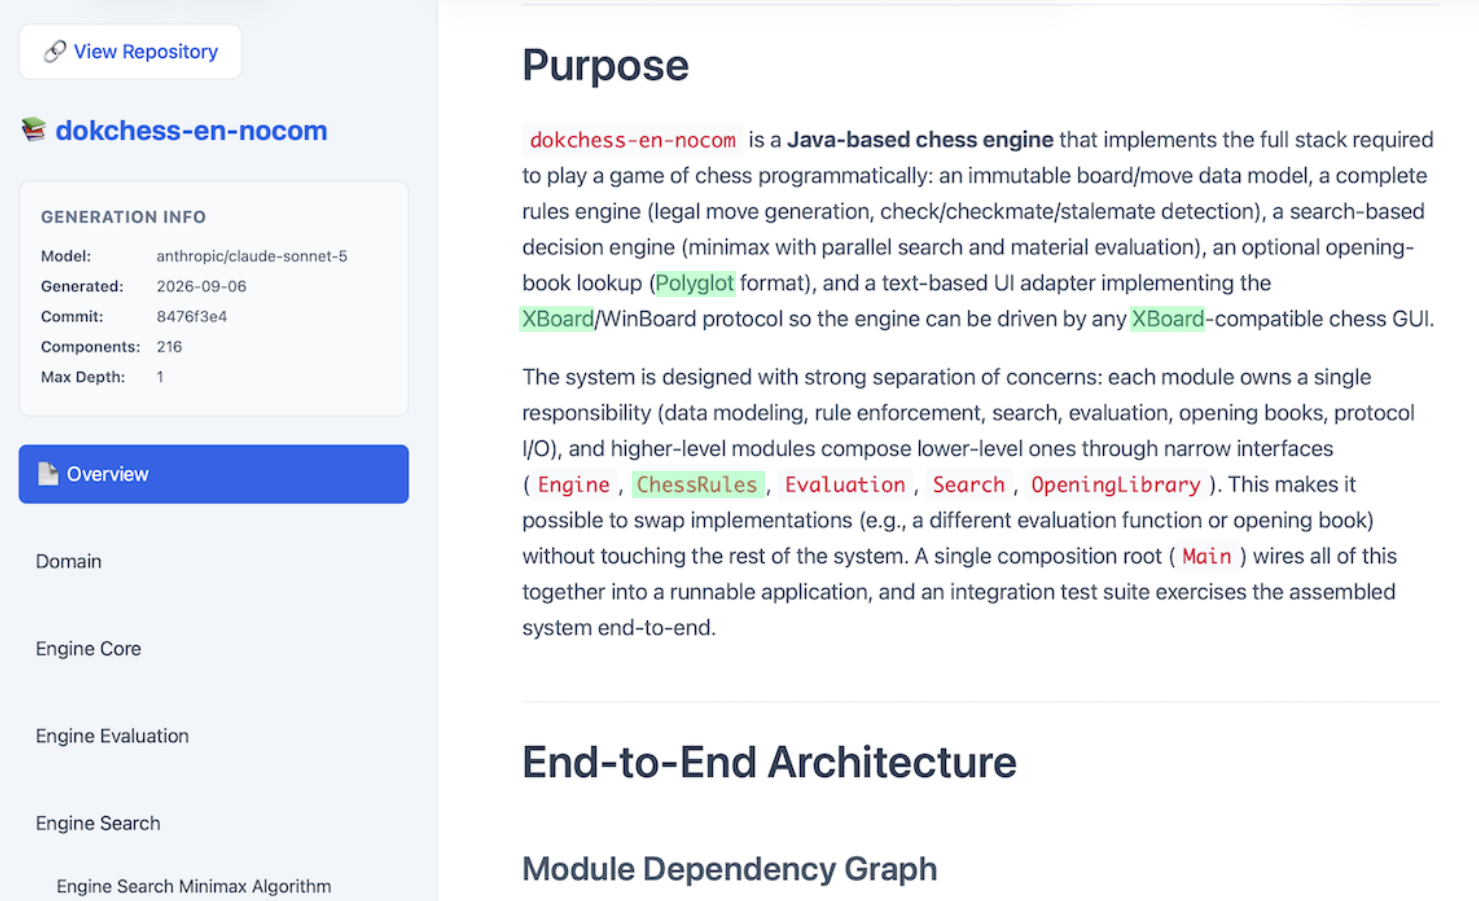
Bei DokChess waren ja zentrale Begriffe wie Polyglot oder XBoard in den LLMs nicht nachweisbar (siehe Tabelle 4), in Überblicken tauchen sie auch bei einem Lauf ohne Kommentare auf (siehe Abb. 4, CodeWiki mit Claude Sonnet 5).
Gegenprobe ohne Agentic Loop
Ein letztes Experiment: Spielen die Begriffe aus den Kommentaren in frühen Phasen des agentischen Workflows von CodeWiki eine größere Rolle? Um das zu prüfen, habe ich den Teil des Agenten, der mit Hilfe eines LLMs die Dokumentation für ein einzelnes Modul erstellt, in ein eigenes Python-Skript ohne die umgebende Agentenschleife (im Wesentlichen das Prompt-Template) isoliert. Dieses habe ich mit einzelnen Quelltextdateien aufgerufen und so getan, als wäre jede davon ein komplettes Modul. Ergebnis ist eine Markdown-Datei (MD) mit Dokumentation pro Aufruf/Datei.
Das Skript habe ich für alle 77 Quelltextdateien von umoria ausgeführt, jeweils mit und ohne Kommentare. Anschließend habe ich je Datei gemessen, wie viele der Kommentarwörter, die nicht bereits im kommentarfreien Quelltext derselben Datei vorkommen (also die linke Seite in Abb. 2, ohne Schnittmenge und englische “Allerweltswörter”), sich in der jeweiligen Mini-Dokumentation wiederfinden lassen.
Tabelle 5 zeigt das Ergebnis für ausgewählte Dateien bei Einsatz von Qwen3-Coder-Flash via OpenRouter. Die Spalte “Kandidaten” nennt die Anzahl verschiedener Kommentarwörter nach obiger Definition, die nächste Spalte wie viele davon in der Dokumentation (Einzelprompt-Lauf) mit und ohne Kommentare vorkommen. Die Beispiele sind Kandidaten, die nur in der Markdown-Variante mit Kommentaren aufgetaucht sind.
| Input-Datei aus umoria-Quelltext | Kandidaten in Komm. | Gefunden in MD-Doku mit / ohne Komm. (Verh.) | Beispiele (aus mit Komm.) |
|---|---|---|---|
| data_creatures.cpp | 148 | 31 / 12 (2,6x) | acid, charmed, frequency |
| rng.cpp | 73 | 28 / 18 (1,6x) | computed, initialized, lehmer |
| curses.h | 15 | 10 / 5 (2,0x) | microsoft, pdcurses, studio |
| data_stores.cpp | 35 | 14 / 6 (2,3x) | alchemy, armory, temple |
Auch wenn ich Allerweltswörter wie “the” oder “some” herausgefiltert habe, sind immer noch gängige Kandidaten dabei gewesen, die sich ein LLM auch so ausdenken kann (z.B. “always” oder “different”). Trotzdem zeigt sich hier ein deutlicher Effekt: In 49 von 77 Dateien gab es mehr Treffer in der Variante mit Kommentaren als ohne (63 %), über alle Dateien hinweg gab es 1107 Treffer mit Kommentaren gegenüber 876 ohne.
Fazit
Zurück zur Frage im Titel: Was passiert denn nun, wenn man CodeWiki – andere habe ich nicht getestet – die Quelltext-Kommentare wegnimmt?
Weniger als erwartet, solange die Bezeichner im Code aussagekräftig sind. In der von CodeWiki erzeugten Markdown-Dokumentation schlugen sich die Kommentare nicht wirklich spürbar nieder. Weder waren sie wörtlich durch N-Gramme nachweisbar noch inhaltlich durch Embeddings. Fragt man dasselbe Modell mit demselben Prompt einzeln nach einer Datei, ist der Effekt dagegen deutlich. Bei knapp zwei Dritteln der Dateien tauchen Informationen auf, die ausschließlich in den Kommentaren stehen. Die Information entgeht dem Modell also nicht, aber sie verschwimmt auf dem Weg zur fertigen Dokumentation. Möglicherweise im agentischen Workflow, wenn CodeWiki mehrere Dateien zu einem Modul verdichtet. Das habe ich aber (noch) nicht im Detail überprüft.
Eine ganz andere Frage wäre, ob und wenn ja wie die inhaltliche Qualität der erzeugten Dokumentation sich ändert, wenn man an der Konfiguration dreht. Interessant ist hier vor allem die Wahl des LLMs, denn diese hat mit Token-Kosten, Generierungsdauer und Datensouveränität zu tun. Aber das wäre ein weiterer Blog-Beitrag. Stay tuned!
Weitere Informationen
- Mein Blog-Beitrag “Sind DeepWiki und seine "Nachbauten" die Zukunft der Architekturdokumentation?” stellt den DeepWiki-Ansatz von Cognition und Alternartiven vor – unter anderem das hier im Beitrag viel genutzte CodeWiki.
- In dem Beitrag hatte ich mit CodeWiki generierte Dokumentation für DokChess verlinkt. Ich habe sie um den Lauf mit einem Quelltext ohne Kommentare ergänzt, der in Abb. 4 zu sehen ist, siehe github.com/DokChess/codewiki-docs
- In dem Beitrag habe ich die Ergebnisse nur ausschnittsweise gezeigt. Details zum Nachvollziehen findet ihr in einem separaten GitHub-Repo. Etwa die extrahierten Kommentare aus den beiden Open-Source-Projekten, Skripte oder vollständige Tabellen und mit CodeWiki generierte Dokumentation.
- Welche Ansätze von GenAI tatsächlich bei Architekturdokumentation helfen und wo die Grenzen dabei sind, ist auch Thema in meinem Seminar “Leichtgewichtige Architekturdokumentation” (“iSAQB CPSA-A ADOC”). Infos und meine nächsten Termine